
在大众认知里,AI模型的运行永远逃不开硬件桎梏:超大参数的大模型只能依托高端电脑、服务器运行,手机受限于有限的内存,只能搭载轻量化小模型,想要运行百GB级大模型几乎是天方夜谭。
但近期开源项目 BigMoeOnEdge 带来了颠覆性突破,彻底改写了端侧AI的硬件边界。依托全新的内存调度与流式加载技术,它成功实现了 12GB 内存手机本地离线运行 91GB 超大MoE模型,全程仅靠CPU推理、无需GPU/NPU加持,输出效果与完整版模型完全一致,真正让旗舰级AI能力下沉到普通移动设备。
一、打破认知悖论:12GB内存为何能承载91GB模型?
常规AI运行逻辑中,设备需要将完整模型权重载入内存才能完成推理,这也是为什么91GB的模型,远超12GB手机内存的承载极限,常规方案会直接加载失败,或因系统频繁内存交换导致彻底卡顿、闪退。
BigMoeOnEdge的核心创新,是彻底摒弃了「全量加载」的传统模式,精准抓住了MoE混合专家模型的核心特性:MoE模型包含数百个小型「专家模块」,但每一次文本生成、每一个token解码,仅会调用极少数对应的专家模块,绝大部分模型权重全程处于闲置状态。
基于这一特性,项目团队重构了端侧AI的运行逻辑:不将完整模型载入内存,仅把高频使用的基础权重常驻内存,单次推理所需的专家模块,实时从手机闪存读取、即用即调,剩余90%以上的模型权重全程储存在机身存储中,无需占用宝贵的内存资源。
这种「按需流式加载」的核心思路,直接把手机闪存纳入内存层级体系,彻底打破了物理内存的容量限制,让设备可以流畅运行数倍、甚至数十倍于自身内存的超大AI模型。
二、核心技术升级:v0.24.0版本全方位优化,速度与稳定性双突破
目前项目最新迭代至 v0.24.0版本,带来了多项关键技术优化,解决了传统流式加载的速度慢、CPU占用高、读写冲突等痛点,大幅提升了手机端的运行体验,所有优化均基于llama.cpp开源框架开发,兼容性极强。
1. 核心优化指令,性能大幅跃升
–release-mmap 内存映射释放:这是本次版本的核心升级。此前llama.cpp会全程占用模型文件的内存映射,Windows平台会出现读写串行拥堵问题,导致多线程读写效率极低。开启该功能后,模型加载完成后自动释放映射内存,重新打通读写通道,桌面端模型推理速度提升46%;安卓手机端虽无读写串行问题,但可降低9%单token CPU占用率,大幅减少手机发热、降频问题。
–row-stream 表单流式读取:针对模型词嵌入表等大型查询表单优化,不再将整张表单常驻内存,仅按需读取当前解码所需的16KB表单片段,在零画质、零精度损耗的前提下,进一步节省内存占用。
–expert-substitute 缓存感知替换(实验级):创新性缓存调度策略,优先调用已缓存的专家模块,仅在精度差距极小时替换缓存内容,大幅减少闪存读写次数,在几乎不影响输出质量的前提下,提升推理效率。
2. 新增旗舰模型适配
新版本正式适配 Qwen3.8-Flash-Next Q2_K 轻量化高密度模型(通义千问4架构预览版),该模型体积约80GB,在12GB手机上可实现3.48 tok/s 的实时推理速度,兼顾超大参数与端侧流畅度。同时优化了分片模型加载逻辑,多分片模型无需手动合并,支持断点续传,大幅降低普通用户的使用门槛。
三、实测数据出炉:12GB手机碾压式运行多款超大模型
项目官方基于 12GB可用内存、UFS 4.0闪存 的普通安卓手机完成多组实测,所有测试均为纯CPU推理、无云端辅助、无精度损耗,数据真实可复现:
-
DeepSeek V4 Flash 0731(284B参数/91GB):当前手机端可运行的最大模型,实测推理速度 0.94 tok/s,可实现实时对话交互,输出效果与电脑端完整版模型完全一致
-
Qwen3.8-Flash-Next(125B参数/80GB):最优状态下可达 3.48 tok/s,流畅支持复杂问答、文案创作、逻辑推理
-
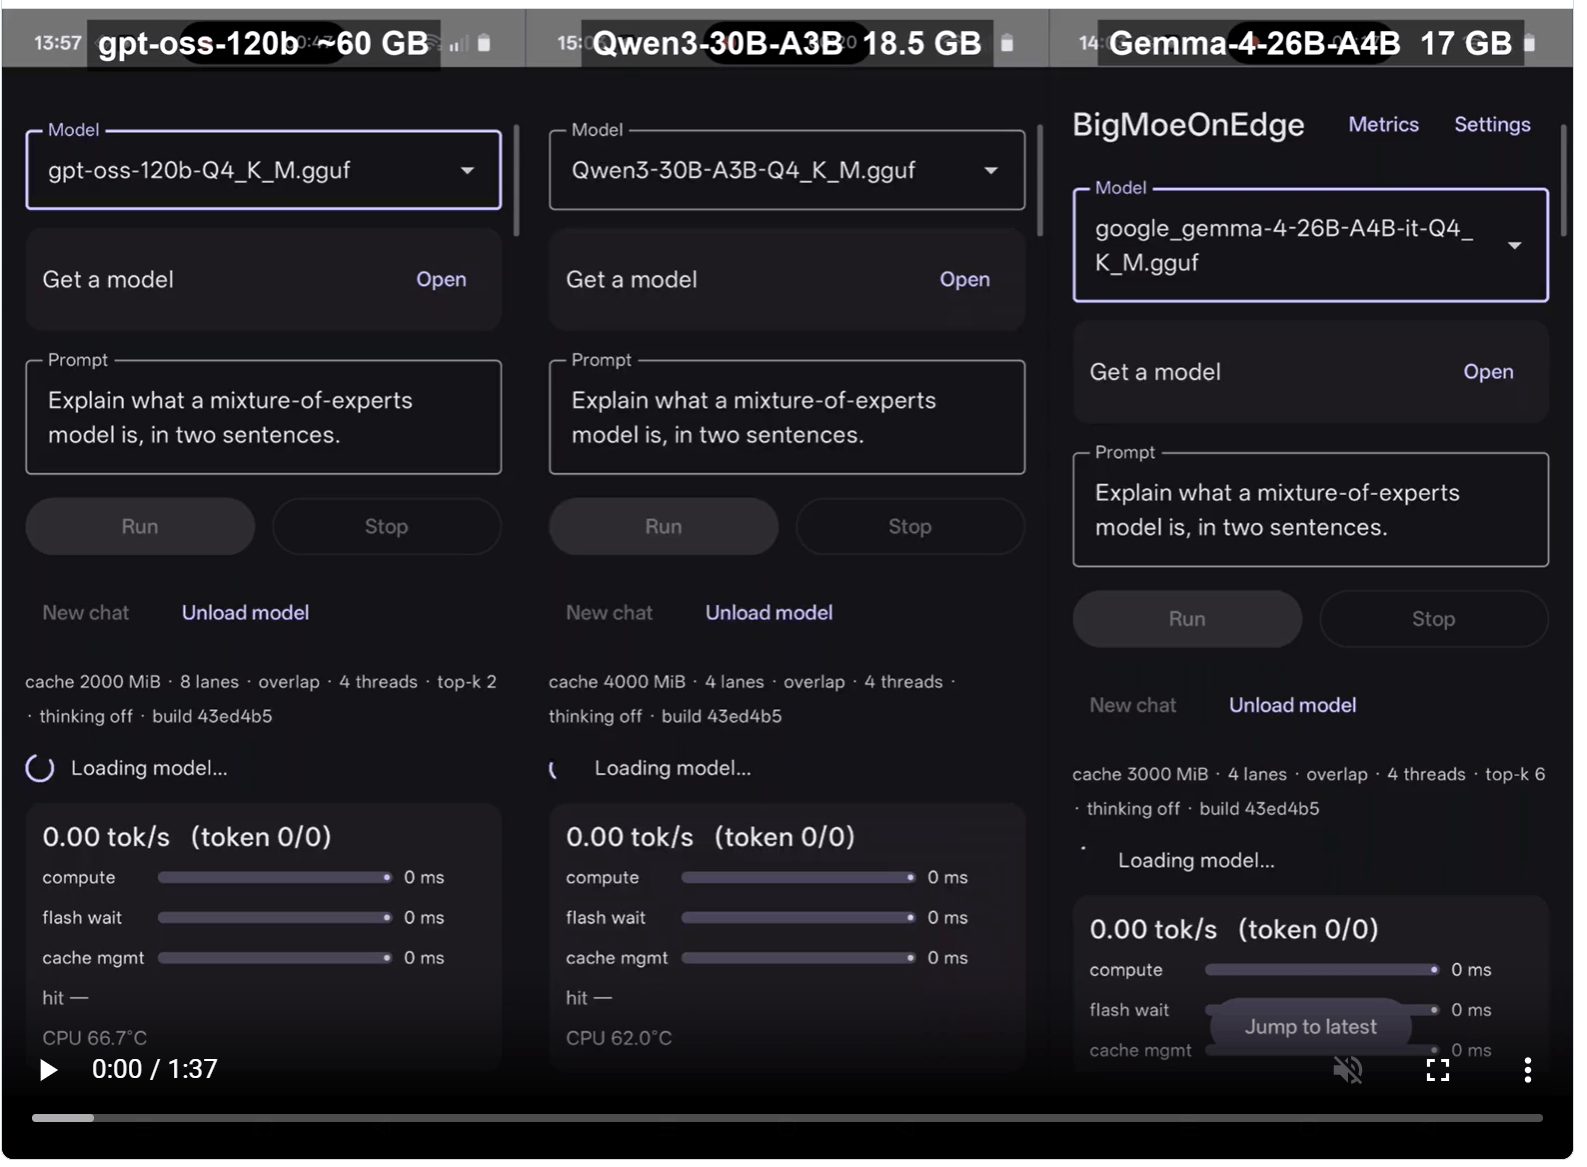
GPT-OSS-120B(60GB):优化缓存策略后,推理速度最高提升3.2倍,稳定运行无卡顿、无闪退
-
中小体量超大模型:Qwen3-30B、Gemma-4-26B、Qwen3.6-35B等17GB-22GB模型,均可稳定运行,相比传统加载方式速度提升200%以上,且不会挤占手机后台应用
对比传统加载方案,BigMoeOnEdge彻底解决了大模型运行的两大痛点:一是小内存设备无法加载超规格模型,二是勉强加载后系统疯狂内存置换、速度暴跌、设备发热严重的问题。同时所有无损模式下的输出内容,与电脑端全量运行结果字节级一致,真正做到高效不打折。
四、不止手机!全平台适配,零门槛落地
BigMoeOnEdge 并非只针对手机优化,项目支持Windows、macOS、Linux、安卓全平台部署,且落地门槛极低,普通用户无需复杂编译操作:
安卓用户可直接下载项目发布的预制APK,内置主流超大模型快捷入口,支持模型断点下载、实时速度监测、缓存自定义调节,一键开启本地AI对话;开发者可通过CLI命令行自定义参数,适配不同硬件设备,优化推理速度与内存占用。
同时项目具备极强的扩展性,新增MoE模型架构仅需简单配置注册,无需重构流式加载核心逻辑,未来可快速适配各类全新开源大模型。目前项目已支持通义千问、DeepSeek、GPT-OSS、Gemma、LFM2等主流系列MoE模型,覆盖对话、创作、推理、编码等全场景。
五、行业价值:重新定义端侧AI的未来边界
长久以来,端侧AI的发展一直被「内存瓶颈」束缚,手机、平板等移动设备只能依靠轻量化模型,能力远不及云端大模型;而本地运行超大模型,又必须依赖高端硬件,成本极高、普及难度大。
BigMoeOnEdge 的突破,彻底打破了这一行业僵局,带来三大核心价值:
1. 硬件降维,普惠全民:无需高端旗舰设备、无需独立显卡,普通12GB内存手机即可运行91GB顶级大模型,让千元机、旧旗舰也能拥有旗舰级AI能力,彻底抹平设备硬件差距。
2. 纯本地离线,隐私绝对安全:全程无云端上传、无网络依赖,所有对话、创作数据仅在本地设备处理,从根源上杜绝隐私泄露风险,适配办公、私密创作、本地数据处理等刚需场景。
3. 拓宽端侧AI应用场景:此前无法落地的本地复杂推理、超长文本创作、高精度问答、离线AI辅助功能,如今均可在手机端实现,为手机AI功能迭代、轻量化端侧AI设备开发提供了全新可能。
六、项目现状与未来展望
BigMoeOnEdge 作为开源公共项目(Apache-2.0开源协议),目前已累计收获数百位开发者Star、数十次Fork迭代,社区持续活跃更新。开发团队仍在持续优化预取调度、缓存策略、跨平台适配能力,未来将进一步提升超大模型的推理速度,降低设备功耗,适配更多移动端、嵌入式设备。
从技术本质来看,这不是单一的参数突破,而是端侧AI运行逻辑的革新。它证明了大模型的落地不再需要堆砌硬件性能,通过极致的内存调度、按需加载的工程优化,就能让普通消费级设备承载顶级AI能力。
随着技术的持续迭代,未来我们或将彻底告别「设备限制AI能力」的时代,人人都能在自己的手机上,免费、离线、安全地使用顶级超大模型,端侧AI的普惠时代,已然到来。
项目地址:https://github.com/Helldez/BigMoeOnEdge
🟡 上手难度:装完还要配一下 —— releases 里有安卓安装包
app-dev-release.apk(22.7MB)和 Windows 命令行版bmoe-cli-v0.24.0-windows-x86_64.zip(2.4MB),装完还得自己下几十 GB 的模型文件放进去。🌐 界面语言:只有英文 —— 界面就是一个聊天框加一排速度数字,认不认英文都看得懂在干什么。
能拿它干什么
-
• 断网的手机上也能问东西。飞行模式下照样出字,坐飞机、下矿井、进厂区禁网区域这类场合用得上。 -
• 手机上用得起大一号的模型。不再受内存那道硬线卡着,存储装得下就能试。 -
• 手上的旧手机拿来当试验机。不用为了跑模型再添硬件,抽屉里那台 12GB 内存的旧机器就是它的目标设备。 -
• 电脑上也能跑同一套。它同时发了 Windows 的命令行版本,先在电脑上试通了再折腾手机。 -
• 看清楚一台机器的真实瓶颈在哪。界面上实时显示每个字花在计算、等闪存、管缓存上各多少毫秒,卡在哪儿一目了然。
它的做法不一样
-
• 它只搬当下要用的那几个专家。混合专家模型由很多小块组成,每生成一个字只用到其中几块,它就只把那几块从存储里读进来,其余的一直躺在盘上。 -
• 输出和全量载入是一模一样的。作者明确说结果是逐字节相同的,不是靠降精度换空间。 -
• 它建在 llama.cpp 的公开接口上。所以 llama.cpp 支持的量化格式、分词器、对话模板它都直接能用,跟着上游升级就行。 -
• 加一个新模型架构只是加一行登记。作者说某个新架构的权重刚放出来当天就在这台手机上跑起来了,比上游支持还早。 -
• 越是「查表型」的架构它越占便宜。模型里那些只是拿来查询、不必常驻的部分,它干脆不加载,只读要用的那几条。 -
• 它自己把慢也摆出来了。演示里 0.94 字每秒的计数就挂在屏幕上,没藏。
要什么配置
-
• 最低。作者演示用的是一台 12GB 内存的手机。真正的硬门槛是存储——那个 284B 的模型在盘上占约 91GB,手机得先腾得出这么大空间。 -
• 实际体验。作者自述:284B 那个模型 0.94 字每秒,125B 的低精度版本 3.48 字每秒。这是「能跑」不是「好用」,一段回答要等好几分钟,演示画面里机身温度到了 91.5°C。 -
• 不用什么。不用显卡,不用联网,不用账号,不用把数据发出去。
怎么跑起来
有现成的安装包,但模型要自己另外灌进去,一共四步:
-
1. 到 releases 页下 app-dev-release.apk(22.7MB)装到安卓手机上;想先在电脑上试就下bmoe-cli-v0.24.0-windows-x86_64.zip(2.4MB)。 -
2. 按文档去下一个支持的混合专家模型,注意看清楚它在盘上占多大。 -
3. 把模型文件拷进手机存储,在应用里指到那个路径。 -
4. 打开对话框问一句,屏幕上会实时显示每个字花了多少毫秒、卡在哪一步。
有件事得说在前面
这是个新项目,2026 年 7 月才开仓,555 星,作者一个人在推。技术路子站得住(建在 llama.cpp 上、输出逐字节一致),但它现在更像一个能跑给你看的验证,不是一件日常工具——0.94 字每秒、机身 91.5°C、先腾出 91GB 存储,这三件事凑在一起,多数人试完一次就会放下。另外 releases 里给的是
app-dev-release.apk,名字里的 dev 说明它自己也没当成稳定版。想看效果又不想灌模型的,仓库里那几段录屏就是全程实拍。
仓库地址:https://github.com/Helldez/BigMoeOnEdge
© 版权声明
1、本网站名称:
X黑手网
2、本站永久网址:https://xheishou.com
3、本网站的文章部分内容可能来源于网络,仅供大家学习与参考,如有侵权,请联系站长进行删除处理。
4、本站一切资源不代表本站立场,并不代表本站赞同其观点和对其真实性负责。
5、本站一律禁止以任何方式发布或转载任何违法的相关信息,访客发现请向站长举报
6、本站资源大多存储在云盘,如发现链接失效,请联系我们我们会第一时间更新。
7.本站原创内容版权归 X黑手网 及对应作者共同所有,欢迎转载,转载请务必注明原文出处及作者信息。
2、本站永久网址:https://xheishou.com
3、本网站的文章部分内容可能来源于网络,仅供大家学习与参考,如有侵权,请联系站长进行删除处理。
4、本站一切资源不代表本站立场,并不代表本站赞同其观点和对其真实性负责。
5、本站一律禁止以任何方式发布或转载任何违法的相关信息,访客发现请向站长举报
6、本站资源大多存储在云盘,如发现链接失效,请联系我们我们会第一时间更新。
7.本站原创内容版权归 X黑手网 及对应作者共同所有,欢迎转载,转载请务必注明原文出处及作者信息。
THE END

暂无评论内容